
2026 年 11 月更新: 补充了 Parakeet Ultra 的公开结果,区分准确率改善、测试条件与没有扩大的语言支持范围。
“Parakeet V3 比 Whisper Large V3 更小、更快,基准成绩也更好。”这样的结论并非完全错误,但对中文用户来说,它忽略了最关键的一点:NVIDIA 官方公布的 Parakeet TDT 0.6B V3 支持 25 种欧洲语言,其中不包括中文。
如果你要在 NVIDIA GPU 上批量处理英文或受支持的欧洲语言,Parakeet V3 很有竞争力。如果你要转写普通话、包含中英文切换的会议,或者希望直接在 iPhone 上离线处理,Whisper Large V3 系列才是更现实的选择。
这也是 LoroNote 使用 Whisper Large V3 Turbo 的原因。它保留了 Large V3 的多语言基础,又把模型缩减到适合 iPhone 和 iPad 日常使用的规模。
先看结论:
- 中文转写应优先选择官方支持中文的 Whisper Large V3 系列。
- Parakeet V3 更适合用 NVIDIA 硬件批量处理其支持的欧洲语言。
- LoroNote 使用 Large V3 Turbo,在中文支持、端侧速度和离线隐私之间取得平衡。
说明:本文由 LoroNote 团队撰写。我们于 2026 年 8 月 10 日核对了 NVIDIA 和 OpenAI 的官方模型卡与技术资料。文中的 NVIDIA 图表已注明来源,也会如实说明 Parakeet 更适合哪些场景。
三个模型快速对比
本文所说的 Parakeet V3 是 parakeet-tdt-0.6b-v3。Whisper 则需要区分完整的 large-v3,以及 LoroNote 使用的优化版本 large-v3-turbo。
| 项目 | Parakeet TDT 0.6B V3 | Whisper Large V3 | Whisper Large V3 Turbo |
|---|---|---|---|
| 参数量 | 6 亿 | 15.5 亿 | 约 8.09 亿 |
| 主要优势 | 支持语言的高吞吐识别 | 广泛的多语言识别与翻译 | 更快的多语言识别 |
| 官方语言范围 | 25 种欧洲语言 | 广泛的多语言覆盖 | 基于 Large V3 的多语言识别 |
| 中文 | 不支持 | 支持 | 支持 |
| 自动语言检测 | 在支持语言内检测 | 支持 | 支持 |
| 翻译为英文 | 不支持 | 支持 | 未针对翻译训练 |
| LoroNote 是否使用 | 否 | Turbo 的基础 | 在设备上运行 |
参数量只能说明模型大小,不能直接代表实际速度。推理优化、内存、录音时长和运行硬件都会影响体验。在 NVIDIA GPU 上测得的吞吐量,不能直接当作 iPhone 上的速度。
Parakeet Ultra 带来了什么变化?
Moondream 于 2026 年 9 月 22 日发布了 Parakeet Ultra。它是 NVIDIA parakeet-tdt-0.6b-v3 的后训练版本,架构、分词器和 6 亿参数规模相同。与面向 CPU 和 Mac 的压缩版 Parakeet Redux 不同,Ultra 保留全精度权重,重点提升识别准确率。
开发者公布的 V3 与 Ultra 准确率
以下单词错误率(WER)来自 2026 年 11 月 5 日核对的 Moondream 模型卡,越低越好。
| 评估条件 | 原版 V3 | Ultra |
|---|---|---|
| 英语,7 个测试集 | 6.26% | 5.80% |
| FLEURS,25 种支持语言 | 11.62% | 9.55% |
| 背景噪声,9 种条件 | 6.72% | 5.82% |
| 长音频,11 段完整 TED-LIUM 演讲 | 2.71% | 1.94% |
FLEURS 的变化是下降 2.07 个百分点,相对 V3 减少约 17.8% 的单词错误。这些是 Moondream 自测结果,并非 LoroNote 实测:Ultra 使用 NVIDIA GPU 上的 Photon,原版使用 NeMo 的 bf16 设置,长音频的分段流程也不同。因此,应将其视为公开运行配置之间的对比,而非只替换权重的控制实验。不能把绝对分数与下方较早的 NVIDIA 图表混用,也不能据此断言 Ultra 比 Whisper 更准确。
速度与中文支持仍需分别确认
Moondream 的吞吐量对比使用 NVIDIA B200、128 个并发请求及不同运行引擎。这不代表 iPhone 上的等待时间或耗电量,仍应在实际使用的应用和设备上测试。
Ultra 保留 V3 的 25 种欧洲语言,并未新增中文、日语或韩语。对支持语言的任务,可以与 V3 一起评估;对中文及更广泛的多语言录音,语言覆盖仍是选择 Whisper 的理由。LoroNote 继续使用 Whisper Large V3 Turbo。
Parakeet V3 为什么受到关注
Parakeet 采用 Token-and-Duration Transducer。简单理解,它可以跳过不太可能产生新文字的音频帧,减少无效计算。官方模型卡还列出了自动标点与大小写、词级和片段级时间戳、语言检测以及长音频支持。
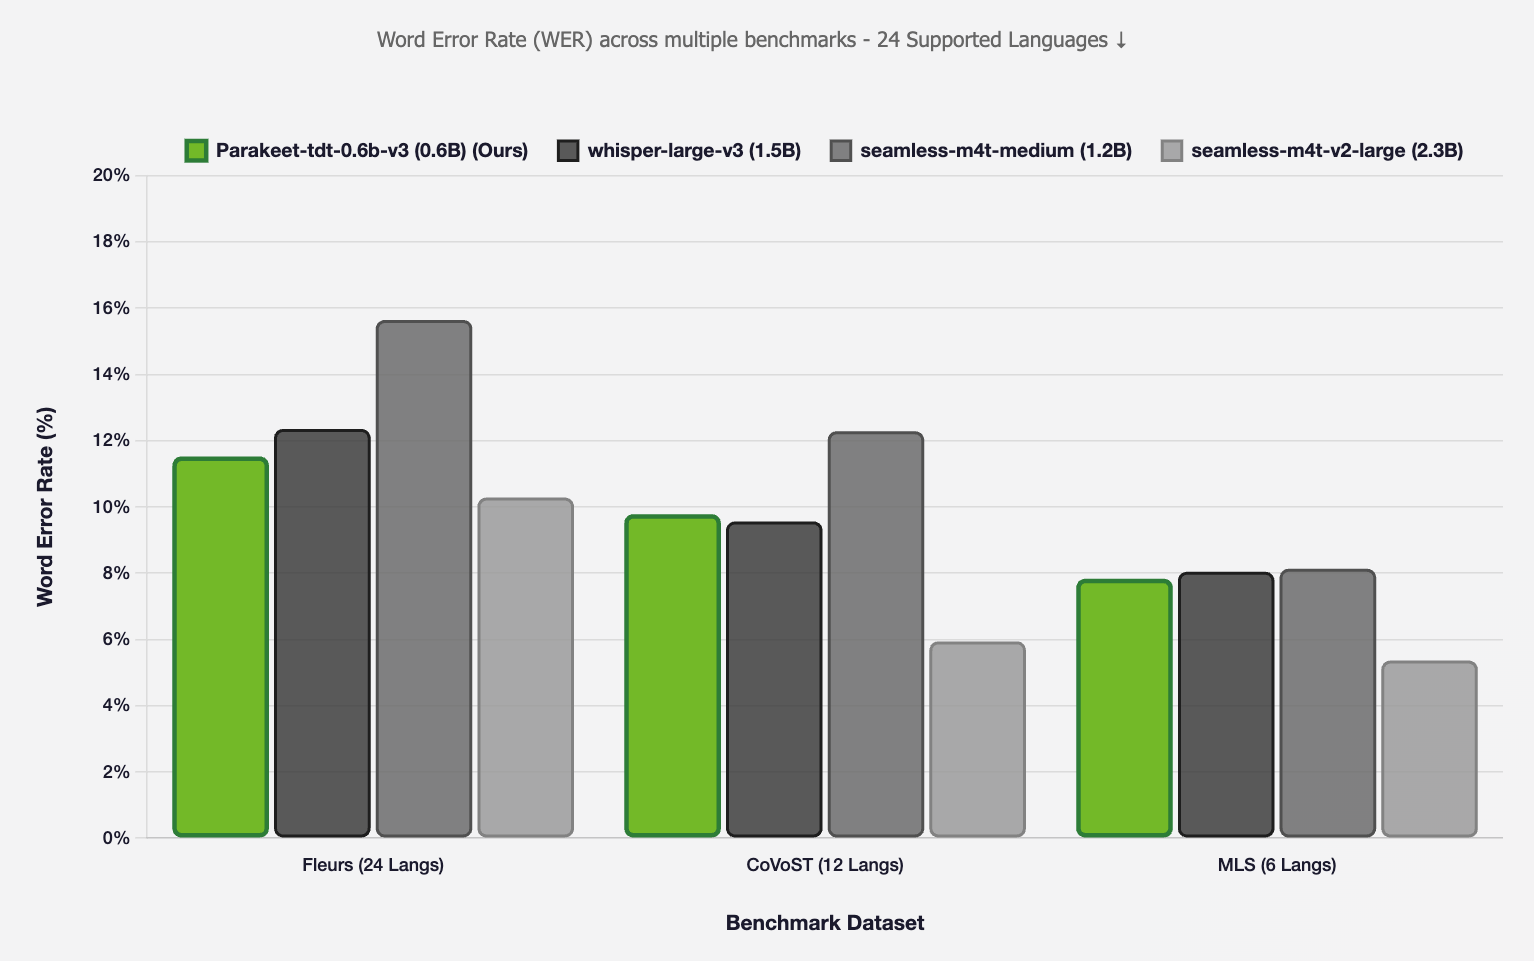
NVIDIA 对 24 种受支持语言的平均 WER 比较。来源:
NVIDIA Parakeet TDT 0.6B V3 模型卡
。CC BY 4.0。
在 NVIDIA 的评测中,Parakeet 在 FLEURS 和 MLS 上的平均词错误率低于 Whisper Large V3;在 CoVoST 上,Whisper 略低。以 6 亿参数对比 15.5 亿参数,这一成绩确实出色。
但图表只统计 Parakeet 支持的语言,中文并不在其中。它也排除了标点和大小写错误,且由 NVIDIA 自行评测。这不是中文准确率测试,也不是 iPhone 上的速度对比。
数字背后的差距
把公开数据放在一起,能让取舍更具体:
- 英文准确率: 在 Hugging Face Open ASR 排行榜上,Parakeet TDT 0.6B V3 的词错误率约为 6.3%,Whisper Large V3 约为 7.4%。这是真实的领先——但也只是每一百个词差一个词左右,麦克风和房间环境对结果的影响远大于此。
- 多语言平均: 在 Parakeet 支持语言范围内的 FLEURS 基准上,NVIDIA 模型卡给出的平均值非常接近——Parakeet 约 12.0%,Whisper Large V3 约 12.6%,各自在不同语言上领先。
- 吞吐速度: Parakeet 的 Transducer 结构在批量场景下快得多,NVIDIA 公布的实时倍率超出 Whisper 一个数量级以上。速度是 Parakeet 最明确、最没有争议的优势。
表格之外还有一个值得了解的行为差异:Whisper 是生成式解码器,OpenAI 官方文档明确指出它可能生成录音中没有说过的内容,最常见于静音或噪声片段。Parakeet 的 Transducer 结构只在检测到语音时输出文字,因此在安静段落更少出现幻听。优秀的应用会围绕 Whisper 做缓解,但就模型原始行为而言,这一分归 Parakeet。
Parakeet 已不再是 GPU 专属——那为什么还选 Whisper?
先诚实地更新一下常见说法:Parakeet 早已不只运行在 NVIDIA 服务器上。转换后的模型可以在 Apple 硬件上本地运行,部分 iOS 和 Mac 应用也正因为它快,把 Parakeet 作为可切换的引擎提供。如果 Parakeet 覆盖你的语言,在手机上运行它是完全合理的选择。
决定性因素在于它覆盖什么。Parakeet V3 的官方范围是 25 种欧洲语言——中文、日语、韩语、印地语、阿拉伯语、泰语、越南语,以及世界上大多数其他语言都不在列表中。Whisper 的训练覆盖约 100 种语言,这就是为什么一个 Whisper 模型可以处理夹着英文产品名的中文会议,或在多种语言之间切换的访谈,而不需要更换引擎。
对一款在许多国家使用的转写应用来说,这个差异是结构性的,不是基准测试的细节。这也是 LoroNote 建立在 Whisper 系列而非更快的英语中心替代品之上的主要原因。
中文场景首先看语言支持
Parakeet V3 的官方支持列表中既没有普通话,也没有粤语。因此,它不适合作为中文会议和课程的默认转写模型。Whisper Large V3 支持中文,也能处理常见的中英文混合表达,覆盖面明显更合适。
支持并不代表所有中文录音都同样准确。人名、品牌名、行业术语、方言、多人重叠说话和远距离收音仍然会增加错误。简体与繁体文字的输出习惯也可能需要后期调整。
粤语用户还要注意:OpenAI 在 Turbo 的官方发布说明中提到,该版本在部分语言上的退化更明显,其中包括 Cantonese(粤语)。如果录音以粤语为主,建议一定使用真实片段测试,不能只参考普通话体验。
LoroNote 为什么使用 Whisper Large V3 Turbo
LoroNote 不是依赖 GPU 服务器的大批量处理平台,而是一款在 iPhone 和 iPad 上把会议、课程、访谈及导入媒体整理成私人笔记的应用。
完整 Large V3 功能强,但对于移动设备上的长录音比较重。OpenAI 在 Turbo 中把解码器从 32 层减少到 4 层,参数量由 15.5 亿降到约 8.09 亿。它保留 Large V3 的多语言基础,同时显著提高转写速度。
这种优化有取舍。OpenAI 说明不同语言的准确度变化并不一致,而且 Turbo 没有针对语音翻译训练。LoroNote 的主要任务是按照原语言生成文字,因此这项取舍更符合应用场景。
除了模型,LoroNote 还提供完整的记录流程:
- 在设备上进行说话人区分
- 点击时间戳回到对应音频
- 为人名和专业词添加自定义词汇
- 导入音频和视频
- 编辑并导出 TXT 或 SRT
另一个常见误区是:用了 Whisper 就一定不上传音频。实际上,是否上传取决于应用如何部署模型。LoroNote 在设备上运行 Whisper Large V3 Turbo 和说话人区分,录音和转写都可以离线完成。完整流程可参考离线语音转文字指南。
应该选择哪一个?
如果任务是批量处理英文或其他受支持的欧洲语言,并且已有 NVIDIA GPU 基础设施,Parakeet V3 是很值得考虑的模型。
如果需要中文、中英文混合录音或更广泛的语言覆盖,Whisper Large V3 系列更合适。对于希望在 Apple 设备上私密转写的用户,Turbo 在识别能力和等待时间之间更实用。
选择前,最好在常用环境中录制 3 到 5 分钟。加入人名、数字、公司名和专业词,再检查漏字、标点、时间戳、说话人切换和处理时间。基准测试比较的是模型,你自己的录音检验的才是最终体验。
常见问题
Parakeet Ultra 新增了中文、日语或韩语吗?
没有。Moondream 说明 Ultra 沿用 V3 的 25 种语言,通过后训练改善公开测试的错误率,并未新增这些语言。GPU 基准也不能直接说明 iPhone 应用的处理速度。
Parakeet V3 支持中文吗?
截至 2026 年 8 月 10 日,NVIDIA 官方模型卡列出的 25 种语言不包括中文,普通话和粤语都不在支持列表中。中文转写更适合使用 Whisper Large V3 系列。
Whisper Large V3 Turbo 和 Large V3 一样吗?
不一样。Turbo 基于 Large V3,但把解码器从 32 层减少到 4 层,因此更小、更快。不同语言会有不同程度的准确度变化,而且它不以翻译为目标。
Parakeet 能在 iPhone 上运行吗?
可以——转换后的模型可以在 Apple 硬件上运行,一些转写应用也因其速度把 Parakeet 作为可切换的端侧引擎提供。但能不能运行已经不是决定因素,语言覆盖才是:如果录音都在 Parakeet 支持的 25 种欧洲语言之内,它是很快的选项;如果包含中文,Whisper 才是真正能转写它们的那一个。
使用 Whisper 会把录音发送给 OpenAI 吗?
不一定,取决于具体应用。LoroNote 在 iPhone 或 iPad 上运行模型,转写时不需要把音频上传到 OpenAI 或 LoroNote 服务器。实际转写速度有多快,可参考我们在 Whisper 应用对比中的实测数据。
对中文而言,能否支持是第一步
Parakeet V3 是一款优秀的欧洲语言高吞吐模型,但中文不在它的官方范围内。Whisper Large V3 提供更合适的语言覆盖,Turbo 则让这套基础能够在个人设备上以更实用的速度运行。
LoroNote 选择 Turbo,是为了识别用户真正会录下的中文和多语言内容,在减少等待的同时,把私人录音留在设备上。